AI가 틀린 조언을 하면, 경험 많은 의사는 더 잘 걸러낼까?
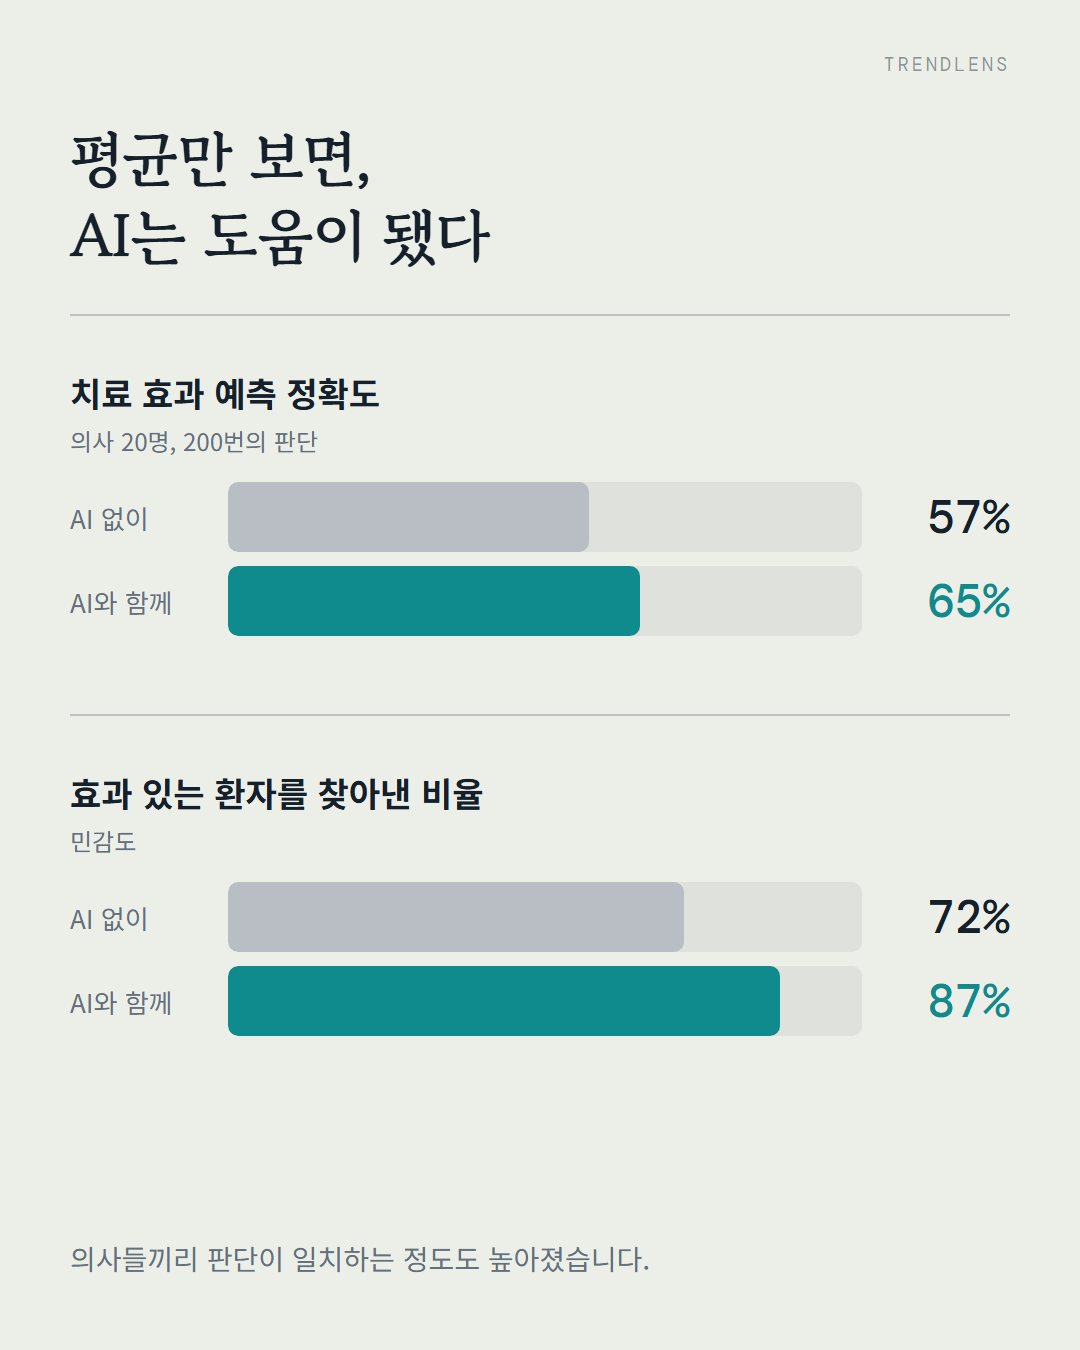
폐암 면역치료 효과를 예측하는 설명형 AI를 의사 20명에게 써보게 했더니 예측 정확도는 57%에서 65%로 올랐다.
핵심 포인트
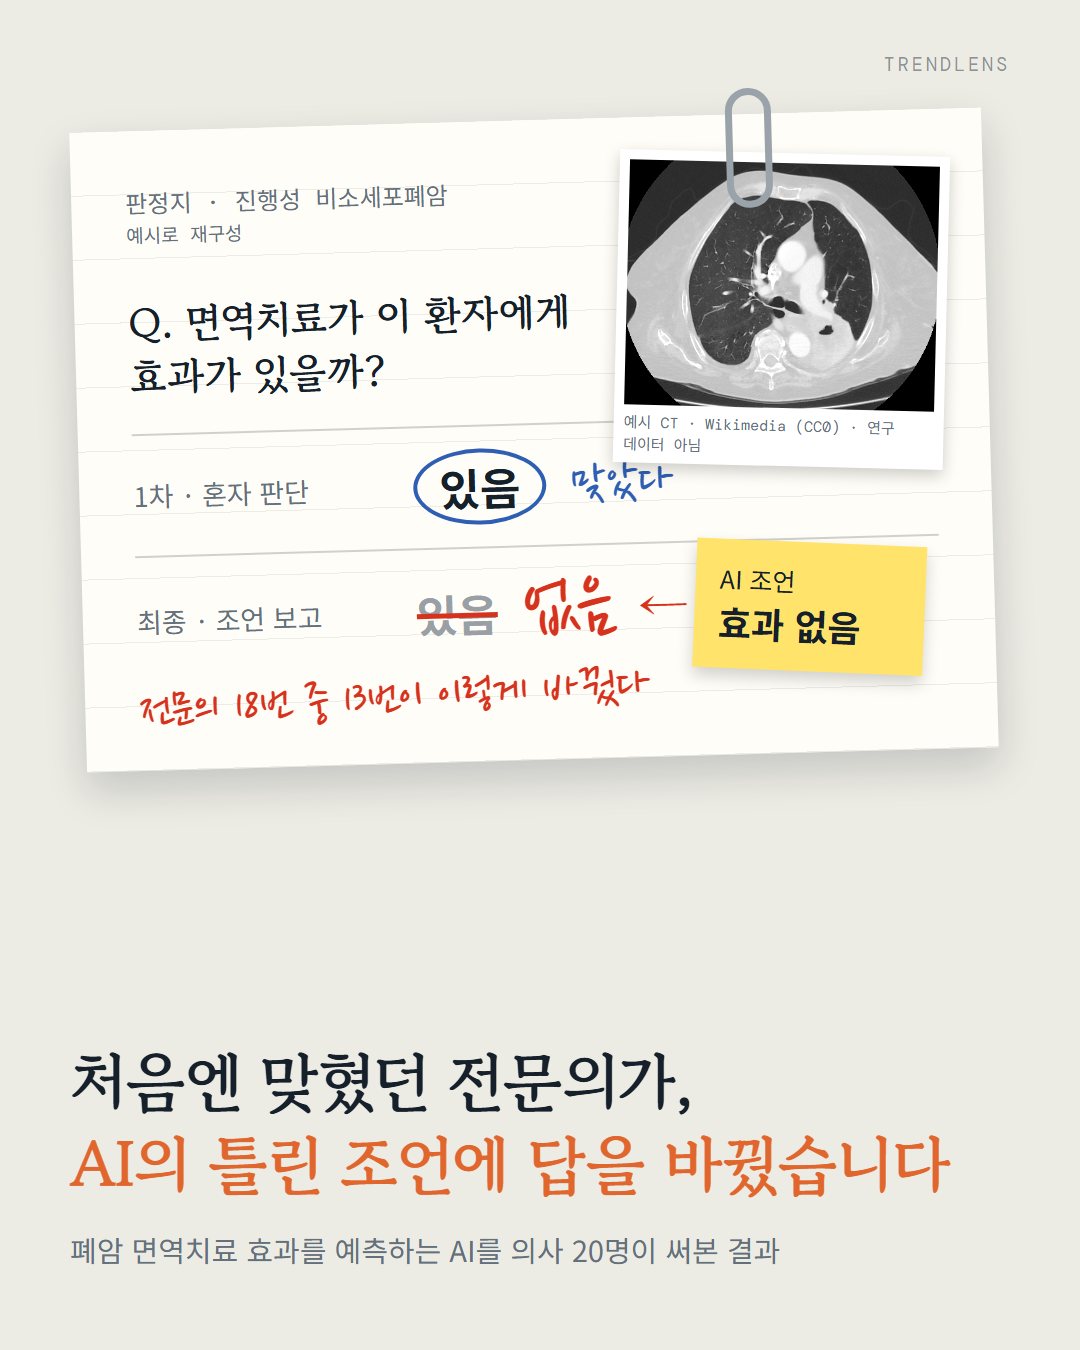
처음엔 맞게 판단했던 폐암 전문의가, AI의 틀린 조언을 보고 답을 바꾼 경우가 많았습니다.
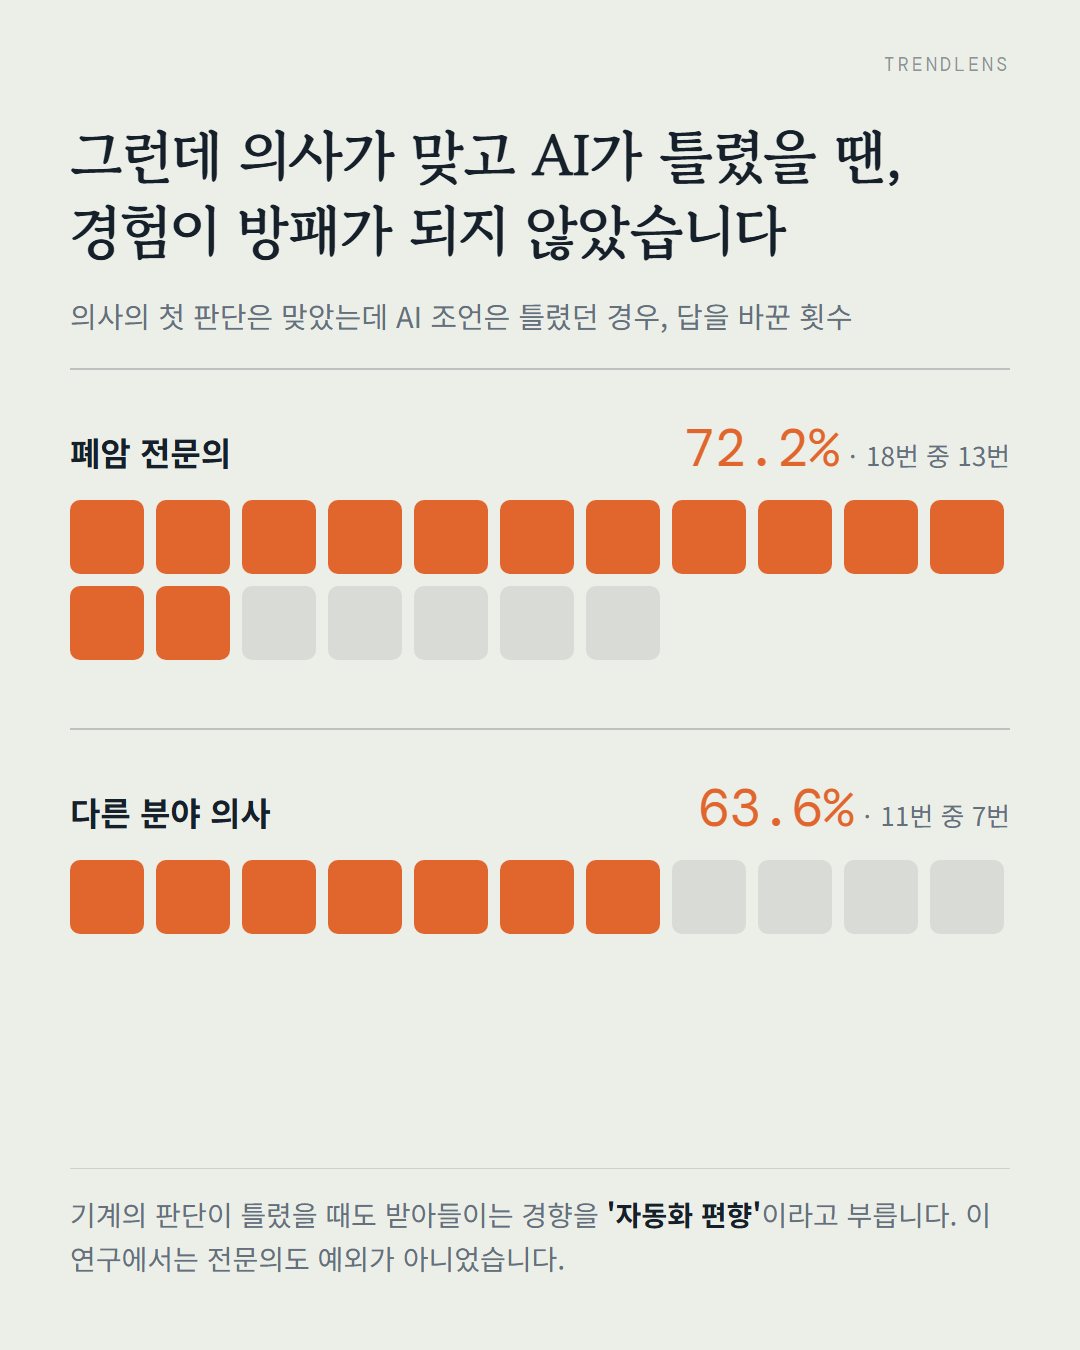
- 그런데 AI가 틀린 제안을 했을 때, 폐암 전문의는 72.2%가 그대로 따랐고 비전문의는 63.6%였다.
- 표본은 작지만, 'AI가 평균적으로 돕는다'는 결과 뒤에 'AI가 틀릴 때 누가 속는가'라는 질문이 숨어 있다.
카드로 보기
자세히
처음엔 맞게 판단했던 폐암 전문의가, AI의 틀린 조언을 보고 답을 바꾼 경우가 많았습니다.
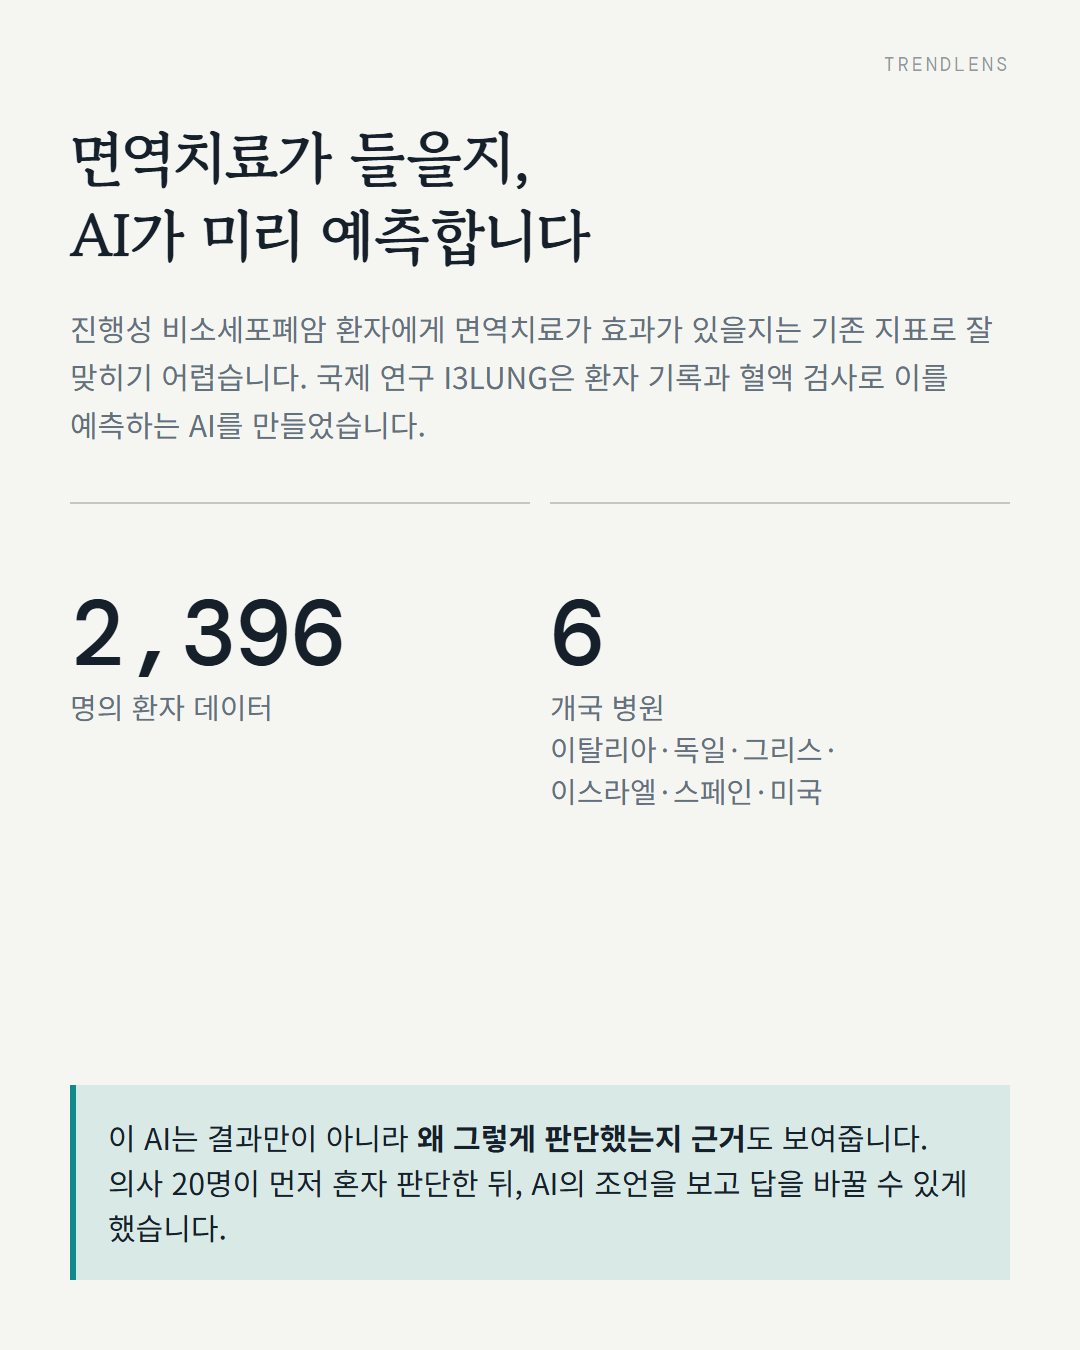
국제 연구 I3LUNG은 6개국 환자 2,396명의 기록과 혈액 검사로 진행성 폐암 환자에게 면역치료가 효과가 있을지 예측하는 AI를 만들었습니다. 이 AI는 결과와 함께 판단 근거도 보여줍니다. 연구진은 의사 20명에게 먼저 혼자 판단하게 한 뒤, AI의 조언을 보고 답을 바꿀 수 있게 했습니다.
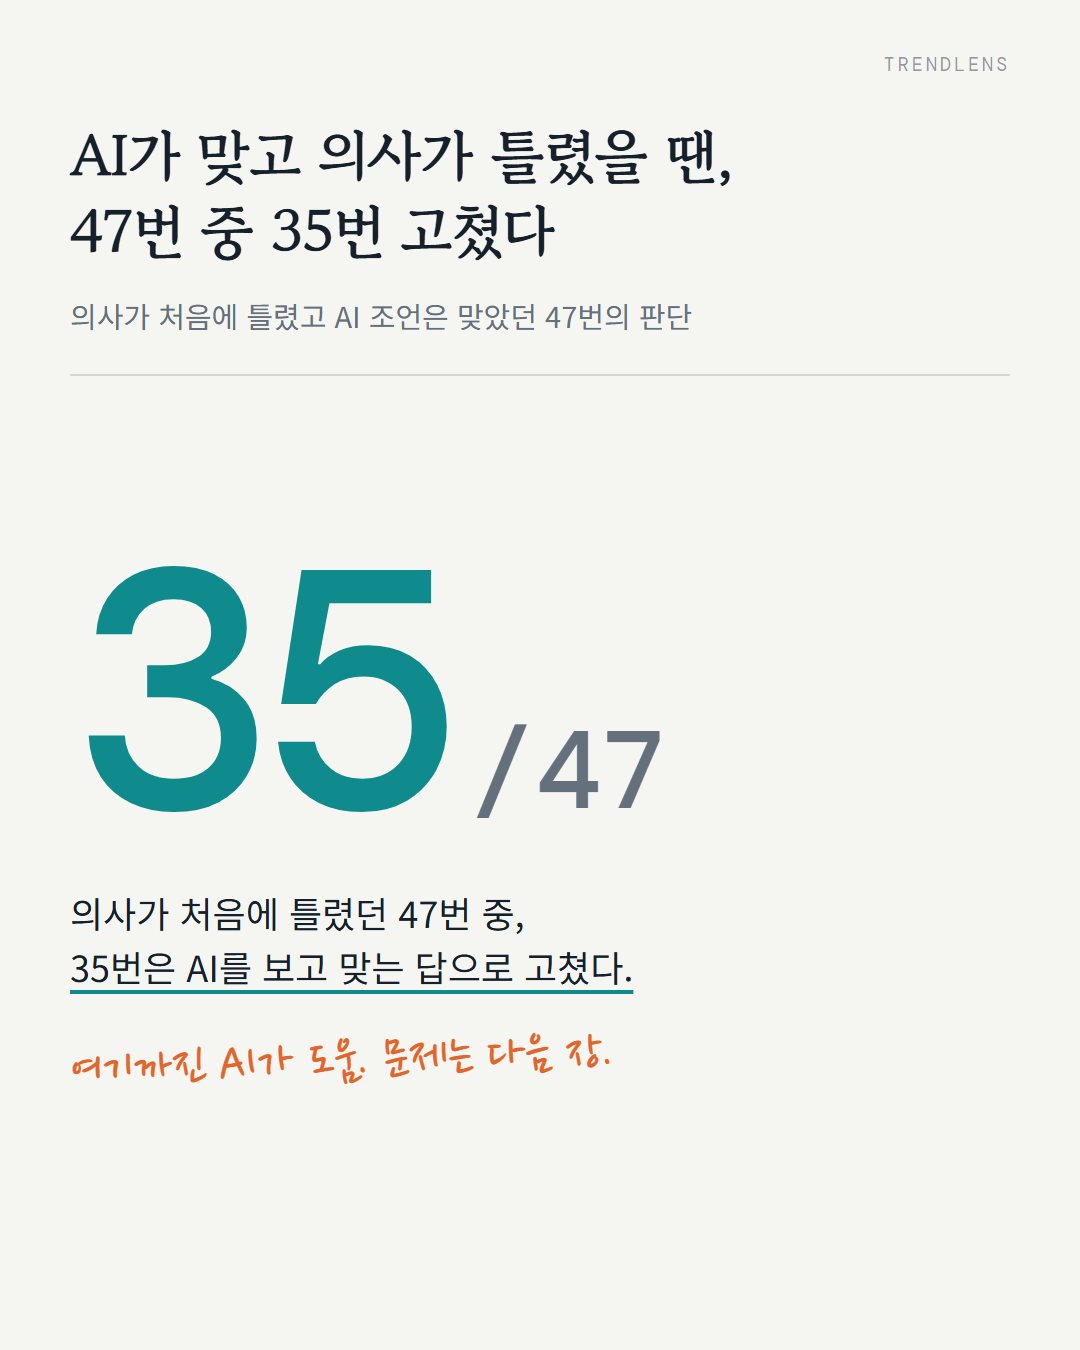
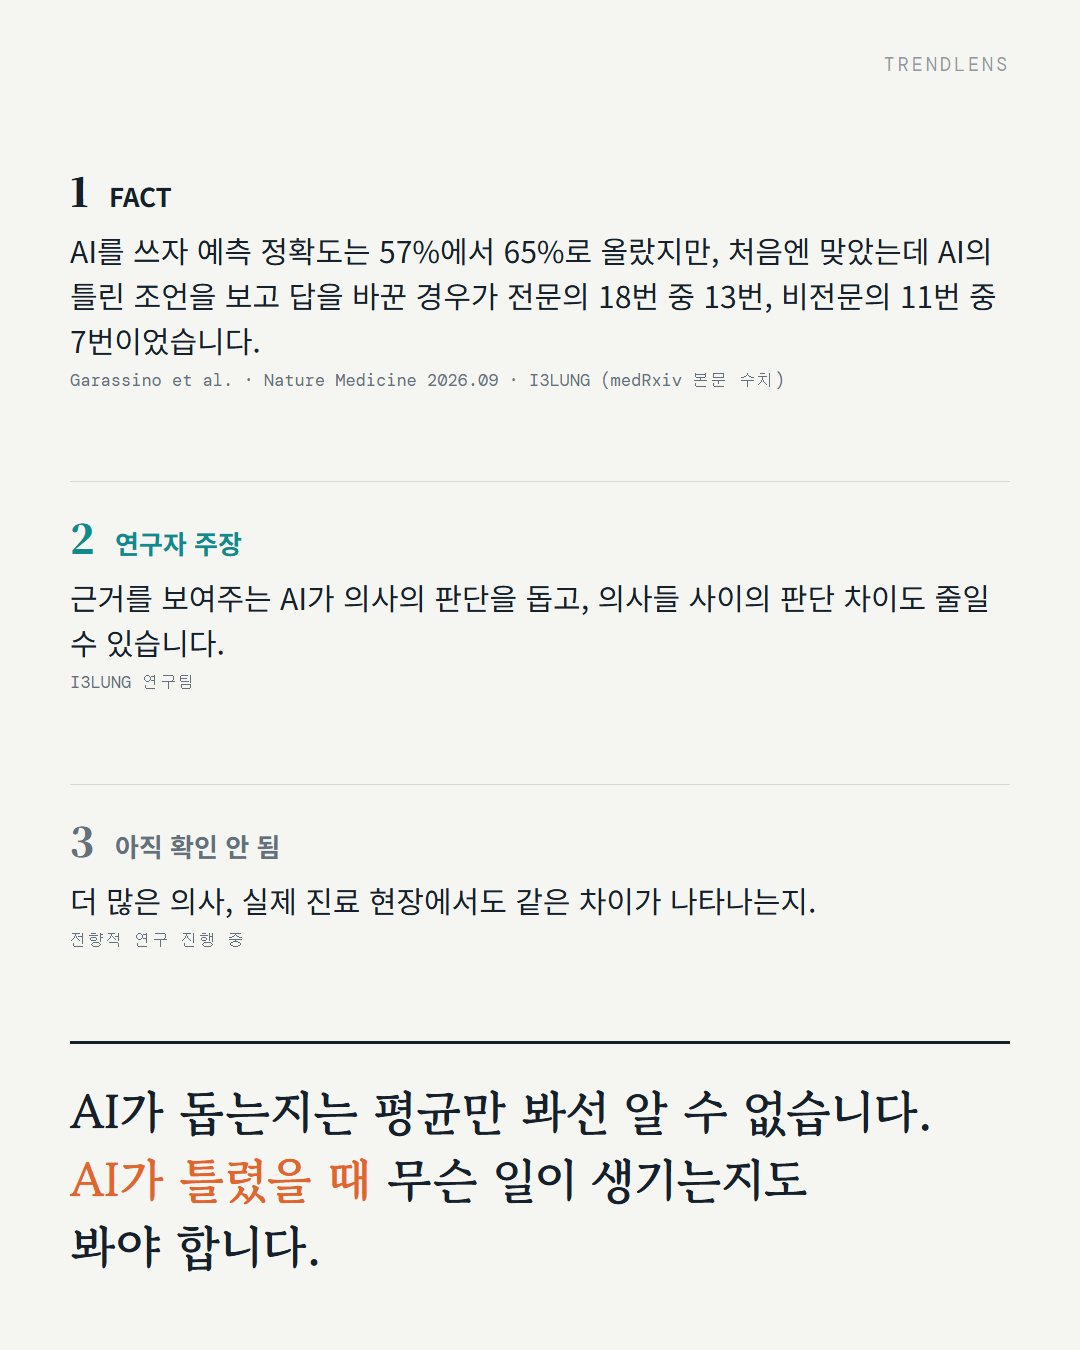
평균적으로는 효과가 있었습니다. 치료 효과 예측 정확도는 57%에서 65%로, 효과 있는 환자를 찾아내는 비율은 72%에서 87%로 올랐고 의사들 사이의 판단도 더 비슷해졌습니다. 의사가 처음에 틀렸고 AI가 맞았던 47번 중 35번(74.5%)은 AI를 보고 맞는 답으로 고쳤습니다.
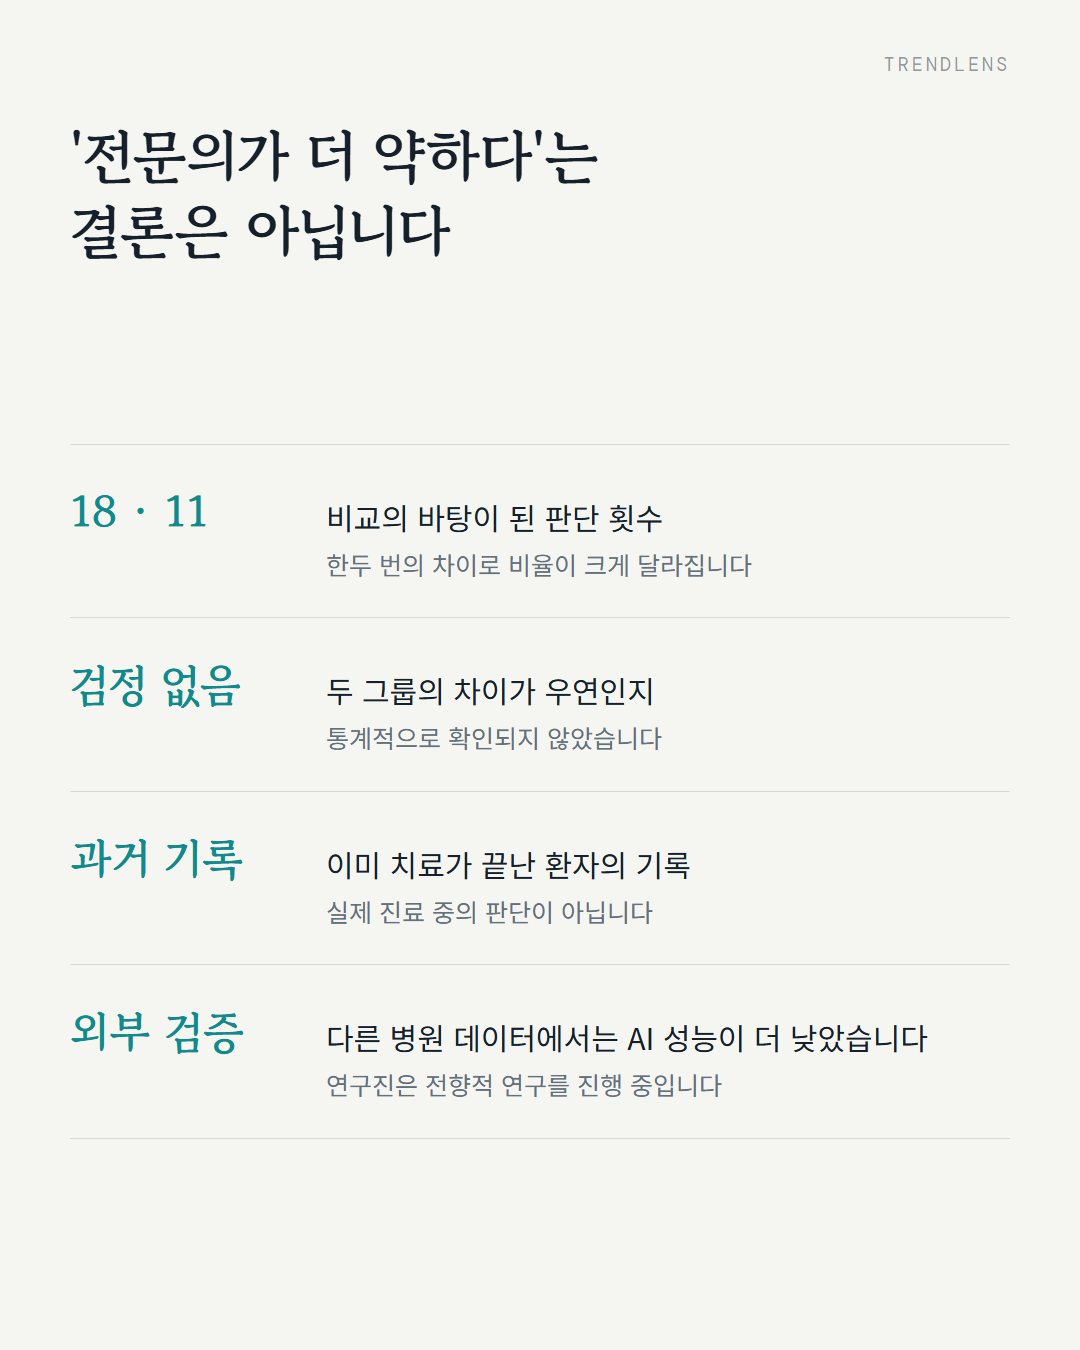
반대로 의사의 첫 판단은 맞았는데 AI가 틀렸던 경우, 폐암 전문의는 18번 중 13번(72.2%), 다른 분야 의사는 11번 중 7번(63.6%) 틀린 쪽으로 답을 바꿨습니다. 기계의 판단이 틀렸을 때도 받아들이는 '자동화 편향'이 전문의에게서도 나타난 셈입니다.
다만 이 비교는 18번과 11번의 판단에 바탕을 둔 작은 결과이고, 두 그룹의 차이가 우연인지는 통계적으로 확인되지 않았습니다. '전문의가 더 약하다'는 결론이 아니라, AI를 평가할 때 평균만이 아니라 AI가 틀린 순간에 무슨 일이 생기는지도 봐야 한다는 신호입니다.
근거
Read medRxiv I3LUNG preprint full text (same study as Nature Medicine s41591-026-04488-2, published 2026-09-13): exact quote 'physicians frequently adopted correct XAI suggestions (74.5%), but experts were more likely to follow incorrect ones (72.2% vs 63.6% for experts and non-experts, respectively)'; DCR accuracy 0.57->0.65 (p=0.0431), sensitivity 0.72->0.87 (p=0.0011); kappa 0.14->0.34; 20 physicians, 200 assessments. News-Medical 2026-09-16: 2,396 patients, 6 centers (Italy, Germany, Greece, Israel, Spain, USA), 10 lung cancer experts + 10 other specialties, retrospective, prospective phase ongoing. BERI summary: external validation AUC 0.55-0.72. Nature Medicine full text paywalled, not read. Full review v2: the 72.2%/63.6%/74.5% were re-derived from the preprint's usability table (read only; the figure itself is 'all rights reserved' and was NOT reused): experts XAI-wrong & initially-correct 13 changed / 5 stayed (13/18 = 72.2%); non-experts 7/4 (7/11 = 63.6%); all physicians XAI-correct & initially-wrong 35 changed / 12 stayed (35/47 = 74.5%). v1 wording ('followed wrong AI 72.2%') was imprecise.
- nature.com https://www.nature.com/articles/s41591-026-04488-2
- news-medical.net https://www.news-medical.net/news/20260916/AI-tools-help-predict-immunotherapy-outcomes-in
- medrxiv.org https://www.medrxiv.org/content/10.64898/2026.01.16.25342913v1.full